第 2 讲 引擎是什么:连接器与工具
【可执行状态】现在就能做
【本讲对应资产】7 个引擎(连接器)、70 个工具
【本讲原理来源】L3 第 20 课《Function Calling 深度解析》、第 18 课《Agent 生态认知革命》
引子:同一间办公室,两种结果
同一个办公室,两位老师,同样用 WorkBuddy,结果不一样。
刘老师(化名)把需求打进去,等它回一段话,然后复制到自己的 Word 里,
调格式、补页眉、改学时写法。她说:“这东西挺好,能帮我打个草稿。”
张老师(化名)说一句话,等几分钟,拿到一个能直接交上去的 docx,
打开核对一遍就完事。她不复制粘贴,也不调格式。
打个比方:这就像两台一模一样的咖啡机——一台接着水管,一台靠人一杯一杯加水。
机器没差别,接没接上水,才是差别。
这一讲不讲操作,只讲清一件事:引擎是什么、有几个、各自管什么。
这是本书后面十七讲的骨架——每一讲都会告诉你,这讲的活是哪个引擎在干。
一、场景
同一间办公室,两位老师,同样用 WorkBuddy,结果不一样。
刘老师(化名)的用法是:把需求打进去,等它回一段话,然后把这段话复制到自己的 Word 里,
调格式、补页眉、改学时的写法。她说:“这东西挺好,能帮我打个草稿。”
张老师(化名)的用法是:说一句话,等几分钟,拿到一个能直接交上去的 docx 文件,
打开核对一遍就完事。她不复制粘贴,也不调格式。
同一个入口,为什么差别这么大?
不是模型不同,也不是谁更会提问。差别只有一个:张老师的入口后面接上了引擎,刘老师的没有。
这一讲不讲怎么操作,讲清一件事:引擎是什么、有几个、各自管什么。
这是本书后面 16 讲的骨架——每一讲都会告诉你,这一讲的活是哪个引擎在干。
二、原理一页:一个入口,七个引擎
1. 先把“引擎”这个词定准
本书反复说“引擎”,给一个说得准的定义:
一个引擎 = 一张脸 + 一条通道 + 一个内核。
>
三件凑齐,一个应用才算真正在 WorkBuddy 里落了地。
把这三件摊开看(用去医院打个比方,一眼就懂):
| 三件 | 是什么 | 医院里的对应 | 老师要管吗 |
|---|---|---|---|
| 一张脸 | 专家卡 / 专家团——有名字的角色,老师找的就是它 | 挂号的科室(内科、骨科、检验科) | 要管:知道找哪个 |
| 一条通道 | MCP 连接器——把能力接进 WorkBuddy 的通道 | 医生开的检查单(通向哪儿) | 认得出名字 |
| 一个内核 | zhenyuonline 上的应用——真正干活的实现 | 后面出结果的检验科、影像科 | 不用管 |
说清这三件,是这一讲的全部任务。 后面十八讲,每一讲都会告诉你:
这句活在 WorkBuddy 里找谁(专家卡)、走哪条通道(连接器)、拿回什么文件。
关键在这里:这三件不是可选项,是一个整体。
- 只有内核(应用)、没有专家卡 → 老师在 WorkBuddy 里找不到它;
- 只有专家卡、后面没接通应用 → 点开了,它也交不出文件;
- 通道接错了应用 → 交出来的东西不是你要的那件事。
所以本书后面说“把某个应用做成一个引擎”,指的永远是这一整套动作:
给它做一张专家卡、接一条连接器、把背后的应用连上。
打个比方:这就像给医院新设一个科室——挂牌子(专家卡)、拉线路(连接器)、
配检查设备(应用)。只挂牌子不配设备,患者进来也是白跑一趟。
2. 七个引擎,一张总表
把七个引擎按上面的三件摊开,就是全书的骨架表(建议这一页折个角):
| 引擎(干哪类活) | 一张脸:专家卡 / 专家团 | 一条通道:连接器 | 一个内核:背后的应用 | 工具数 | 对应讲次 |
|---|---|---|---|---|---|
| 教学内容的设计与实现 | 知言(教师备课助手) | lesson-agent | 备课引擎 | 11 | 第 3—7 讲 |
| 教学管理的资料自动化填制 | 教学资料填制员 | doc-filler | 填制引擎(含模板库) | 6 | 第 8—13 讲 |
| 课题与科研的实现与修改 | 科研助手专家团(团长:科研助理) | research-assistant | 科研引擎 | 8 | 第 14—17 讲 |
| 作品与竞赛应用建设 | 数智应用建造师 | app-builder | 建造器引擎 | 8 | 第 18 讲 |
| 完整业务示范(全链条) | 普洱跨境运营官 | puer-crossborder | 普洱跨境应用 | 12 | 第 19 讲 |
| 数据类应用(估值/指数/寻源/课程) | 明算、观澜、权衡等 | zhenyuonline | 平台上的 20 个应用 | 20 | 拓展用 |
| 外文资料翻译 | 通译(文档翻译官) | pdf-translate | 翻译服务 | 5 | 第 14 讲起配合 |
七个引擎一共 70 个工具。
3. 两类角色:一张卡,还是一个团
上面那张表里出现了两种形态,先分清:
| 形态 | 是什么 | 怎么用 | 真实的例子 |
|---|---|---|---|
| 专家卡 | 一张卡 = 一位有名字的“专员” | 点开它,直接说你的活 | 知言(教师备课)、通译(文档翻译)、教学资料填制员、文献侦察员、课题申报专员、数智应用建造师 |
| 专家团 | 一个团队 = 多个角色的协作组,有团长 | 面向一类跨步骤的复杂任务 | 科研助手专家团(科研助理+文献侦察员+资料管理员+课题申报专员+论文写手,团长是科研助理) |
一句话区别:专家卡是“找一个人办一件事”,专家团是“找一个团队办一类事”。
日常的活(出一份教案、填一批作业)用专家卡最快;
跨步骤的活(从查文献到写申报书到改论文)交给专家团,它会按顺序把活派下去。
再记一遍那句话:说“这活交给某个引擎”,意思就是——
在 WorkBuddy 里找到它那张脸(专家卡),说一句话,它顺着通道(连接器)去调背后的应用干活。
4. 为什么能力放在引擎里,而不是全塞进入口
这是 2025—2026 年 AI 应用最重要的一次结构变化,值得记住:
入口做薄,能力做厚。
入口只负责三件事:听懂你的话、决定用哪个工具、把结果拿给你看。
真正的活——读文件、填模板、算学时、查数据库——全部放在引擎里,一样一样做成工具。
这么做有三个好处,每一条都对应教师的一个实际困扰:
- 换模型不用改流程:今天用这个模型,明年换更强的,引擎里的工具不用重写,你的习惯不用重学。
- 能力可以点名:工具都有名字(如
filler_batch、lesson_gen)。有名字才能被叫到,
也才能被写进书里、说给别人听、做成一面可复用的“能力墙”。
- 能验收:每个工具都有明确的输入和输出。做没做成,不看它怎么说话,看它交没交出文件。
5. 工具的真名长这样
工具在系统里的全名由三段拼成:
mcp__<引擎名>__<工具名>例如把一批学生的结课作业填出来,用的是:
mcp__doc-filler__filler_batch这三段读法:mcp = 这类能力的通用协议名(Model Context Protocol,模型上下文协议);
doc-filler = 引擎名;filler_batch = 工具名。
你不需要背这些名字,但你需要在两个场合认得出它们:
一是排错时看日志,二是给同事或学院写材料时说明“我们用的是哪条链路”。
本书附录 A 有一张完整的工具速查表。
6. 七个引擎,各自的关键工具
这本读本说的所有活,都由七个引擎承担。按你手上的活分,是这样一张对照表
(这是全书的目录骨架,建议这一页折个角):
| 你要干的活 | 引擎 | 工具数 | 看看在哪一讲 |
|---|---|---|---|
| 教学内容的设计与实现 | lesson-agent | 11 | 第 3—7 讲 |
| 教学管理的资料自动化填制(含模板库) | doc-filler | 6 | 第 8—13 讲 |
| 课题与科研的实现与修改 | research-assistant | 8 | 第 14—17 讲 |
| 作品与竞赛应用建设 | app-builder | 8 | 第 18 讲 |
| 完整的业务示范(全链条) | puer-crossborder | 12 | 第 19 讲 |
| 数据类应用(估值、指数、寻源) | zhenyuonline | 20 | 拓展用 |
| 外文资料翻译 | pdf-translate | 5 | 第 14 讲起配合用 |
七条通道一共 70 个工具。
先看前三个——也就是你日常最多的那三类活:
教学内容(lesson-agent,11 个工具):把课程资料变成教案,再变成能放的课件、能收成绩的练习。
关键工具是 lesson_gen(生成教案草稿)、lesson_revise(按你的意见改)、
lesson_finalize(按学院模板定稿)、lesson_deck(生成网页课件)、quiz_create 与 quiz_scores(出练习、收成绩)。
教学管理填制(doc-filler,6 个工具):把数据填进学校的 Word 模板,一次出一批;
模板可以是内置范例,也可以是老师自己上传的(第 9 讲专讲这件事)。
关键是 filler_templates(看模板库)、filler_template_info(要准备什么数据)、
filler_template_upload(上传自己的模板)、filler_run(出一份)、
filler_batch(按名单出一批)、filler_check(核对是否真填完)。
课题与科研(research-assistant,8 个工具):文献、术语、申报书、论文一路做下来。
关键是 lit_card(文献精读卡)、grant_extract_dict(把已填申报书解成课题字典)、
grant_fill(字典 + 模板 → 全套文档 + 校验报告)、paper_draft(写章节草稿)、
docx_polish(正式排版)。
7. 一条判断:这事有没有“带名字的工具”在干
读到后面,你会遇到很多“这件事能不能做”的问题。用一个问题就能判断:
这件事,有没有一个带名字的工具在干?
- 有名字(如
filler_batch)→ 能做,而且是确定的、可验收的 - 没名字,只有“AI 大概能帮你” → 那是聊天,不是引擎,别指望它交文件
8. 一条演进线:AI 应用是怎么长成今天这样的
例如,2022 年的大模型应用,基本是“一个模型加一个聊天框”——问它答、答完你自己动手;
2023 年出现插件,能查天气、能读文件,但每接一个能力都要给这个平台单独做一次适配,
就像家里每来一件新电器就要重新布线;
2024 年前后,工具调用(Function Calling)成熟,模型第一次能看懂一份“工具说明书”
并按说明书准备参数;到了 2025—2026 年,MCP 这样的标准协议出现,
能力终于成了可以“插上去”的插座——同一个能力,谁都能接,不用为每个平台重做一遍[1]。
打个比方:这就像电源插头的标准化。早年各国插头形状不同,出国要带一包转接头;
后来统一了标准,电器走到哪儿都能插。引擎这个概念能成立,靠的正是这次“插头标准化”。
再比如,这件事在软件行业早有先例:早年每个软件都要自己写打印功能,
后来有了系统级的打印服务,所有软件都调它。能力被抽出来、被标准化,是效率跃升的前置条件。
三、动手三件套
先看一眼:这三步在界面上长什么样
下面三张图是同一次真实操作的三个阶段。请对照你自己的界面看一遍——从“说一句话”到“拿到东西”,
中间只有三个画面。
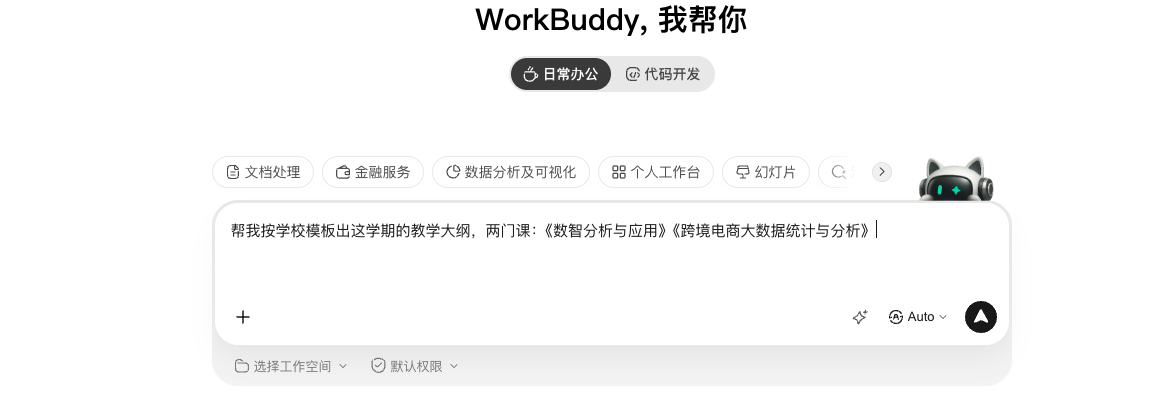
第一步,说需求。 你不用挑引擎,也不用填表。把要办的事写进这个框里就行——说清“做什么、按什么来、给谁用”三件事。
图里这句话是:“帮我按学校模板出这学期的教学大纲,两门课:《数智分析与应用》《跨境电商大数据统计与分析》”。
注意框下面那两个选项:工作空间和权限。工作空间决定它能看见你哪些资料,权限决定它能写到哪儿去——
这两项是后面每一讲出活前都要确认的(附录 C 有详解)。
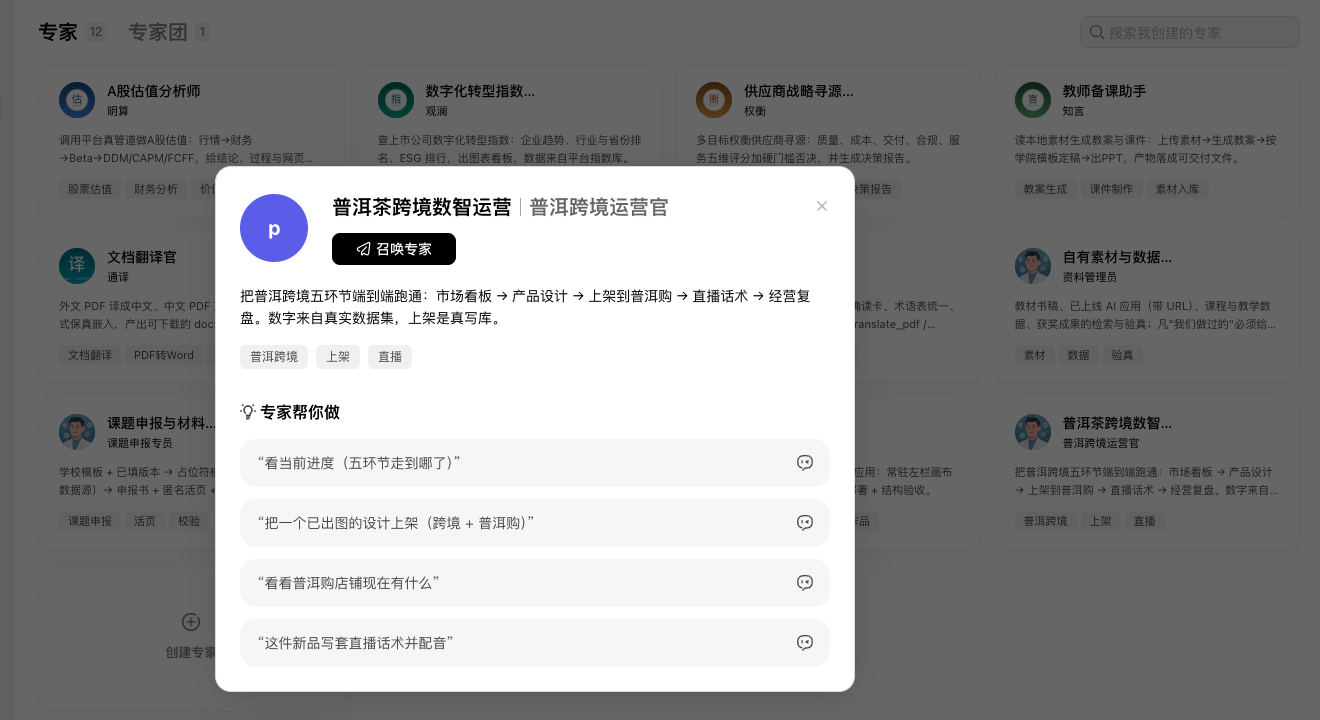
第二步,选人。 点「专家·技能·连接器」→「我的专家」,你接进来的每个引擎都在这里有一张带名字的卡。
主页面上那些卡(明算、观澜、权衡、知言、通译……)都是这么来的:一台引擎,一张卡,一个名字。
点卡片上的「召唤」,它会把“能替你干什么”摊开给你看——那几条就是这张卡背后引擎的主要入口。
“有名字才被调用”这句话,在界面上就是这个样子。
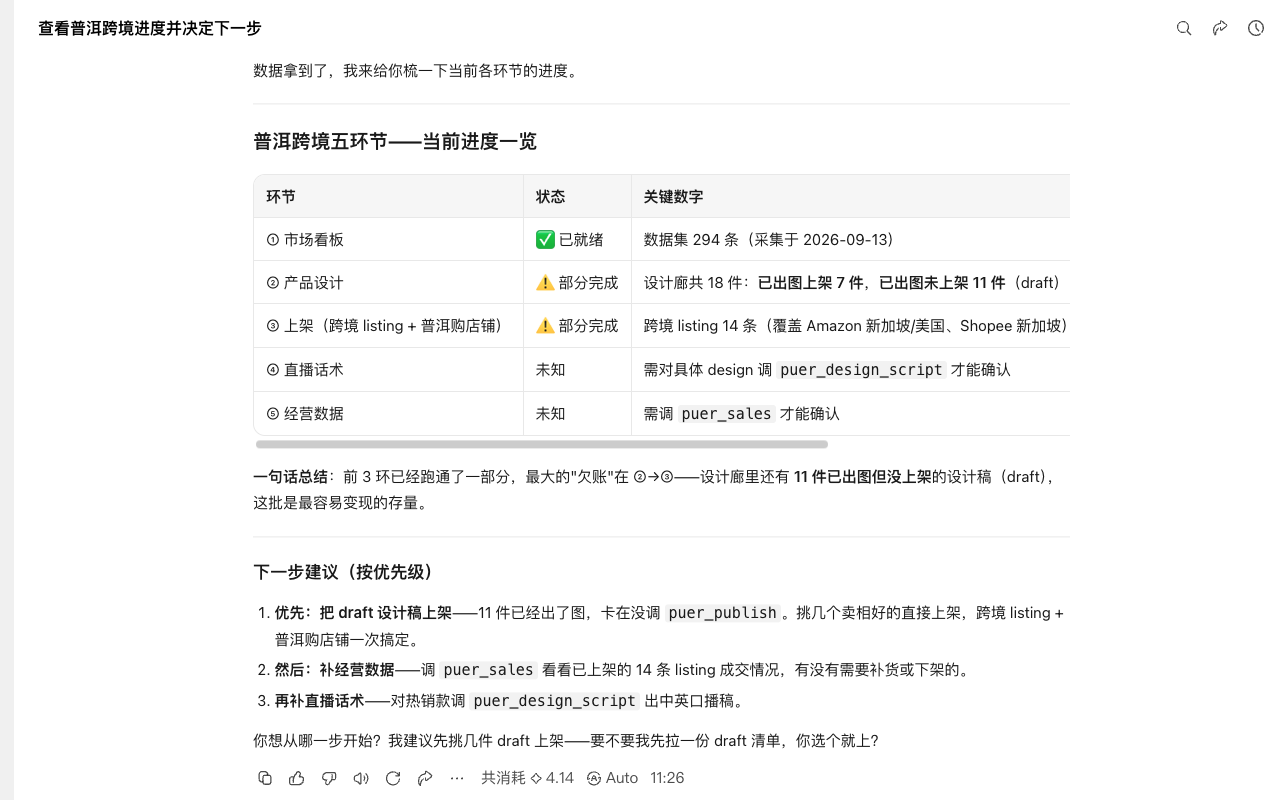
第三步,收结果。 看这张图里的回答:数据集 294 条、设计廊 18 件、跨境 listing 14 条、店铺在架 14 件——
这些数字不是它编的,是它调引擎从数据库里取回来的。判断一台引擎有没有真跑,就看这一点:
它给你的是你系统里的数,还是像模像样的一段话。
顺便注意图里那行小字“已完成 22s”。这是这台引擎的真实响应时间——22 秒里它做了这么几件事:
认领任务 → 调工具查进度 → 汇总 → 给下一步建议。快,是因为它调用的是现成的工具,不是现推的公式。
这三步合起来,就是本书每一讲都会重复的结构:
你说一句话 → 找一张带名字的卡 → 拿回一个能打开的东西。
一句话指令
“我现在接了哪几个引擎?每个引擎能干什么?按我手上的活列给我。”
预期产物
一张《我的引擎清单》。照下面的样子填,第三列写你自己这学期真实要干的活:
| 引擎 | 工具数 | 能替我干的活(写你的真实任务) | 我打算先试哪个 |
|---|---|---|---|
lesson-agent | 11 | 例:《商业数据分析》第四章教案与课件 | |
doc-filler | 6 | 例:下学期课程大纲与教学进度表(用学校自己的模板) | |
research-assistant | 8 | 例:两篇英文文献的精读卡 | |
app-builder | 8 | 例:带学生做的省赛作品站 | |
puer-crossborder | 12 | 例:想看看完整链路怎么走 | |
zhenyuonline | 20 | 例:课堂演示用的数据看板 | |
pdf-translate | 5 | 例:泰文合作材料翻译 |
校验点
逐行自查三条:
- 数目对得上:前三个引擎的工具数分别是 11、6、8。对不上,说明你看到的入口和我这本读本讲的不是同一套配置,
先看附录 C 的连接器配置。
- 每条活都写出了引擎名:只写“AI 帮我做大纲”不算,要写成“用
doc-filler出大纲”。 - 至少一行是你本周真要交的:把它圈出来,那一行就是你接下来要读的那一讲。
四、常见错误与排错
错误一:只装了入口,没接引擎。
表现是:界面看起来正常,但让它出文件时,它只能给你一段文字。
原因:入口和引擎是两件事,引擎要单独配置(见附录 C)。
排错:问一句“我现在接了哪几个引擎”。答不上来或数目不对,就是没接好。
错误二:引擎连上了,但被“信任门”拦在门外。
表现是:配置文件里明明写了这个引擎,它却不用。
原因:新连接器第一次用需要登记信任,否则会被安全机制静默跳过——不报错,只是不用。
排错:看日志里有没有 skipping untrusted server 这样的字样。这是本书排错部分最常出现的一条,
附录 C 有完整的处理步骤。
错误三:明明有引擎,模型却不去用。
表现是:它自己动手写了一段 Python 代码,想“模拟”填制,结果格式和学校模板对不上。
原因:工具要在指令里被点到名,模型才倾向于调用它。
排错:在指令里直接点名,例如“用 filler_batch 把这批学生作业按模板出出来”。
本书每一讲的指令模板都带了工具名。
错误四:三个场景混着用。
表现是:想批量出作业,却去用了备课引擎,来回试半天。
排错:回到本节第 4 点那张表——先定场景,再定引擎,顺序不要颠倒。
错误五:把工具数当成绩。
表现是:以“我们有 70 个工具”为成果。
排错:工具数是能力储备,不是交付。能交付的是文件。每一讲都有一条“预期产物”,
产物拿不到,工具再多也没用。
五、边界与红线
- 引擎在服务器上跑,数据要出本机。公开教材、自己写的教案、已公开的政策文件可以传;
学生个人信息、未公开的科研数据、涉密合作材料不要传(见第 12 讲的学生名单处理方式)。
- 引擎只做确定的执行,判断留给人。它能把数据填进模板,不能替你决定课程目标该怎么写。
- 引擎的能力有边界,别拿它当万能。它擅长“有模板、有规则、有数据”的活;
没有模板、没有标准答案的活(比如“帮我想想这门课该怎么改”),它只能给草稿,判断还是你的。
- 引用工具要写清名字。教研材料、申报书里写“使用 AI 工具”太模糊,
写成“使用 doc-filler 引擎的批量填制工具”才可复核。
六、拓展与学科迁移
- 跨专业的引擎对照:同是
doc-filler,电子商务专业可以填选品报告、财务管理专业可以填预算说明、
国际经济与贸易专业可以填报关材料——引擎不变,模板和数据换掉,这就是第 8 讲讲的那道公式。
- 把“引擎清单”变成专业建设材料:一个专业把这七个引擎里用到的部分列出来,
就是一份《专业 AI 应用能力清单》,可以直接进专业建设与教改申报。
- 下一步:给自己的学科做一个引擎。当你发现某类活重复到第十次、而且每次规则都一样,
它就到了该被做成引擎的时候——第 19 讲会展示一个完整的例子。
带走一句话
入口做薄,能力做厚——换个更强的模型,你的流程不用改。
参考文献
[1] Anthropic. Introducing the Model Context Protocol[EB/OL]. https://www.anthropic.com/news/model-context-protocol.(MCP 作为开放标准,使能力可被不同应用复用)
[2] OpenAI. Function calling[EB/OL]. https://platform.openai.com/docs/guides/function-calling.(工具的描述与参数如何决定模型能否正确调用)
背后的引擎(本讲速查)
| 你在书上看到的话 | 在 WorkBuddy 里找谁(专家卡/专家团) | 走哪条通道(连接器) | 工具全名怎么读 |
|---|---|---|---|
| 出教案、改教案、定稿、出课件、出练习 | 知言(教师备课助手) | lesson-agent | mcp__lesson-agent__lesson_gen |
| 出大纲、批量出作业、用自己上传的模板 | 教学资料填制员 | doc-filler | mcp__doc-filler__filler_batch |
| 文献精读卡、申报书、论文 | 科研助手专家团(团长:科研助理) | research-assistant | mcp__research-assistant__lit_card |
| 作品站、看板、货架 | 数智应用建造师 | app-builder | mcp__app-builder__app_scaffold |
| 全链示范(市场→设计→上架→直播→复盘) | 普洱跨境运营官 | puer-crossborder | mcp__puer-crossborder__puer_status |
| 外文资料译成中文 Word | 通译(文档翻译官) | pdf-translate | mcp__pdf-translate__pdf_translate |
本讲要点(速记)
- 一个引擎 = 一张脸 + 一条通道 + 一个内核:专家卡/专家团 + MCP 连接器 + zhenyuonline 上的应用
- 一个入口:WorkBuddy——老师说一句话,说给某个有名字的角色听
- 一句结构:入口做薄,能力做厚——换个更好的模型,你的流程不用改
- 一条命名:
mcp__<引擎>__<工具>,三段读得懂,就能排错、能写材料 - 七个引擎 70 个工具:教学内容 11、填制 6、科研 8、作品 8、全链 12、数据 20、翻译 5
- 一条判断:这件事有没有一个带名字的工具在干?有 = 能做且可验收,没有 = 那还是聊天